Оптический процессор распознал дипфейки в 15 параллельных видеопотоках с точностью 97,79%
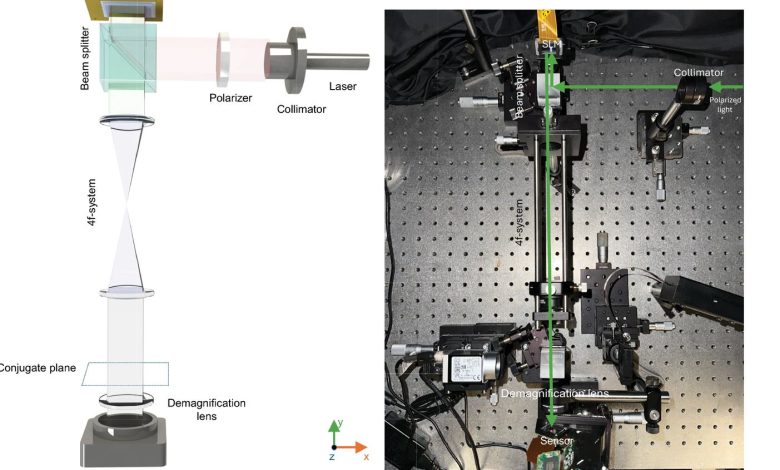
Исследователи создали экспериментальный процессор, который использует распространение света для одновременной проверки сразу 15 видеопотоков на дипфейки. В испытаниях система определяла поддельные видео с точностью 97,79%, причём часть вычислений выполнялась непосредственно оптическим способом. Технология рассчитана на массовую первичную проверку видео, когда необходимо быстро отбирать подозрительные ролики для последующего более подробного анализа.
Систему разработали Парниан Гапандар Кашани, Шици Чэнь и Айдоган Озджан из Калифорнийского университета в Лос-Анджелесе. Вместо полностью цифровой нейросети исследователи объединили небольшой цифровой модуль с оптическим процессором. Первый извлекает из видеозаписи необходимые признаки, а второй использует свет для окончательной классификации ролика как настоящего или поддельного.
Главная особенность разработки заключается в параллельной обработке данных. Информация сразу от 15 независимых видео кодируется в одной фазовой структуре на пространственном модуляторе света. После этого свет проходит через оптическую систему, а на выходе фотодетекторы регистрируют интенсивность сигнала в областях, соответствующих каждому видеопотоку. Сравнение пар сигналов позволяет определить, к какому классу относится каждый ролик.
Таким образом, свет фактически выполняет часть операций, для которых в обычной нейросети потребовались бы электронные вычисления. При этом все 15 видео проходят через оптический декодер одновременно за один цикл распространения света, а не последовательно одно за другим.
Работу экспериментальной установки проверили на Celeb-DF — наборе настоящих и поддельных видео с лицами. Для слепого тестирования исследователи использовали 105 настоящих и 105 поддельных роликов, которые не участвовали в обучении. Из них сформировали 21 тысячу вариантов тестирования с различным выбором кадров и распределением видео между 15 оптическими каналами.
При одновременной проверке 15 видео экспериментальная система достигла средней точности 97,79%. Чувствительность, то есть способность правильно обнаруживать поддельные ролики, составила 99,86%, а специфичность — способность правильно распознавать настоящие видео — 95,72%. Численное моделирование той же архитектуры дало близкую точность 98,12%, что показало хорошее соответствие между расчётной моделью и физической оптической установкой.
Исследователи попробовали увеличить число одновременно анализируемых роликов до 18. Система продолжила работать, однако экспериментальная точность снизилась до 96,13%. Причиной стало усиление взаимного влияния оптических каналов при их более плотном размещении. Поэтому вариант с 15 видео оказался более удачным компромиссом между количеством одновременно обрабатываемых данных и качеством распознавания.
Отдельно учёные проверили систему на значительно более современных полностью сгенерированных видео. Для этого использовали ролики, созданные моделью Veo 3 через Gemini. Такой тест важен, поскольку методы генерации искусственного видео быстро меняются, а детектор, обученный на старых дипфейках с заменой лиц, может плохо распознавать контент новых генеративных моделей.
После дополнительной настройки цифровой части всего на 50 сгенерированных видео систему протестировали на отдельном наборе из 105 настоящих и 105 искусственных роликов. При параллельной обработке 15 видео физическая установка достигла 94,80% точности, чувствительности 97,61% и специфичности 92,00%. Поэтому показатель 97,79% нельзя распространять на любые современные ИИ-видео — он относится к конкретному тесту Celeb-DF.
Авторы также подвергали видео сжатию, добавляли шум и размытие и имитировали неточности выравнивания компонентов экспериментальной установки. Кроме того, систему проверяли против состязательных атак — специально подобранных изменений входных данных, предназначенных для того, чтобы заставить алгоритм ошибиться. Оптический декодер сохранил работоспособность при этих воздействиях.
Ещё одно потенциальное преимущество связано с энергопотреблением. В оптической части необходимые преобразования происходят при физическом распространении света, поэтому для каждой математической операции не требуется отдельное электронное вычисление. Авторы сравнили систему с несколькими цифровыми декодерами и получили более выгодное сочетание энергозатрат и точности для ряда конфигураций.
Производительность системы при этом ограничивается главным образом не скоростью распространения света, а электроникой, которая кодирует входные данные. Авторы рассчитали, что при использовании пространственного модулятора с частотой 180 Гц одна партия из 15 видео может обрабатываться примерно за 5,56 миллисекунды. Более быстрый фазовый модулятор с частотой 1440 Гц потенциально уменьшает это время примерно до 0,69 миллисекунды на группу из 15 видео, хотя этот вариант оценивался отдельно и отличается характеристиками фазового кодирования.
Технология пока не является универсальным детектором, способным гарантированно определить происхождение любого ролика из интернета. Точность зависит от типа подделки и данных, использованных для обучения. Даже в тесте с Veo 3 часть искусственных роликов система принимала за настоящие. Поэтому исследователи предлагают использовать оптический процессор прежде всего как первую ступень проверки большого потока информации. Подозрительные видео после такого отбора можно передавать более сложным и ресурсоёмким цифровым моделям.
Такой подход потенциально позволяет использовать один оптический процессор для непрерывной проверки большого количества поступающих видеозаписей. Количество одновременно анализируемых потоков можно увеличивать за счёт расширения доступной площади оптической системы, хотя эксперимент уже показал, что слишком плотное размещение каналов способно снижать точность. Следующим этапом станет дальнейшее масштабирование архитектуры и её проверка на новых поколениях генераторов видео.
Исследование в журнале eLight.